通过 ACP 把 Antigravity 和 Apache/Maka 接进 Raft
最近我开始在日常工作流里尝试多 Agent 协作工具,前后深度测试了 Cumora 和 Raft。相比之下,我更偏好 Raft 的 Agent 定义 / 交互 / 频道组织方式等,顺理成章就想把平时主力在用的多个编码 Agent 接进去,包括 Codex、Claude Code、Antigravity,以及 Apache 孵化的开源 Agent Maka(用来接 DeepSeek 用)。
Codex 和 Claude Code 这种比较热门的自然没啥问题,但 Raft 官方支持的 runtime 列表里没有 Maka,而 Antigravity 的支持被标记了 deprecated,观察 Raft 的 runtimeAdmissionService 目前做法是看到这个名字会直接返回 400 Bad Request。
那能不能直接改 Raft 源码、给它加个 Adapter?答案是也不太现实。虽然 Raft 放出来的源码仓库 botiverse/raft-source 采用 FSL-1.1-ALv2(Source Available 协议)允许个人修改自用,但这个仓库目前只是按版本导出的只读镜像,不接受外部 PR;如果自己 fork 维护一套魔改版,不仅每次升级都要手动同步快照,连接官方服务时还会卡在服务端 runtime 白名单和客户端签名校验上。
在翻看 Cumora 和 Raft 的源码研究它们怎么对接外部 CLI 时,我拆解了 agy 的三种调用方式(见上一篇文章),并注意到了 ACP(Agent Client Protocol)。而翻到 Raft 的 Grok 接入源码时(即 packages/daemon/src/drivers/grok.ts),我们发现其底层跑的也是 ACP 协议。
这个发现直接打开了一条不用动 Raft 源码的新路子:写一个薄薄的 grok 代理脚本放到 PATH 前面位置,借用 Raft 现成的 Grok adapter,把请求按 ACP 协议分发给 Antigravity、Maka 或其他兼容 ACP 的 Agent。
为什么是 Grok Build
在一切开始之前,我们先 clone raft-source 仓库做一轮实验。
Raft 早期废弃的 antigravity.deprecated.ts 走的是每轮对话重新起一次 agy chat -m 子进程的方式,即每次都是独立的单轮对话;改成常驻 stream-json 管道后可以获得非每轮冷启动的多次对话,显著提高了 Raft 这类群聊场景的性能;而我们其实还能把 grok.ts 复制一份改成直连 agy_acp_server.par,如上一篇文章分析 ACP 其实比 stream-json 有更多的优势。
但既然不能直接改客户端,那就反过来学习下 packages/daemon/src/drivers/grok.ts 到底是怎么工作的:
- 它通过
lookupCommandOnPath("grok")在环境变量PATH里找可执行文件; - 执行两条探测命令确认 CLI 可用:
grok --version和grok agent stdio --help; - 会话开始即执行
grok agent --no-leader --always-approve stdio,开始收发 ACP 消息。
这里有个 macOS 上的小细节:GUI 应用默认拿不到终端里的 PATH,但 Raft 在 packages/computer/src/shellEnvCapture.ts 里专门做了一步处理,启动时会拉起用户的登录 shell(-ilc)执行 __print-env 把环境变量抓回来。
所以重点就是:把我们的代理脚本软链到 ~/.local/bin/grok,Raft 的 Desktop.app 就能直接识别到它。然后,代理脚本需要在收到 --version 时回复版本号,在收到 agent stdio --help 时回一段帮助文本,完成基础的探针工作。之后的难点就都在 stdio 的协议对齐上了,举两个最基础的握手差异:
- 第一,Raft 的
GrokDriver在发完initialize之后会直接调session/new,但agy的 ACP 服务要求必须先调一次authenticate({ methodId: "oauth-personal" }),否则建会话会直接报未认证错误。这步我们在代理层转发session/new前加个调用即可。 - 第二,Raft 会把频道的常驻指令(Standing Prompt)塞进
session/new请求的_meta.systemPromptOverride字段里,而这不是标准 ACP 字段,agy和 Maka 都会忽略它。代理层需要先把_meta.systemPromptOverride摘出来存好,等该会话收到第一条session/prompt时,再连同当前工作目录、操作系统、时区等环境信息一起拼到首轮 prompt 前面(Maka 的 Runtime Host 会自己注入环境上下文,因此只对agy补环境信息)。
一个 Adapter 对应多个 Agent:前缀路由与真 CLI 共存
当把 agy 跑通后,我就准备把 Maka(maka acp)也接进来。这时马上遇到一个问题:所有 Agent 共享同一个 grok 入口,怎么区分当前会话该对接哪个实际的 Agent?
Raft 在创建或配置每个 Agent 时可以填自定义的环境变量,所以我在代理层加了一条规则:每个 Agent 必须显式配置 GROK_SHIM_PROFILE=agy 或 GROK_SHIM_PROFILE=maka。如果没配这个变量,代理层在 session/new 和 session/load 阶段会直接抛错。
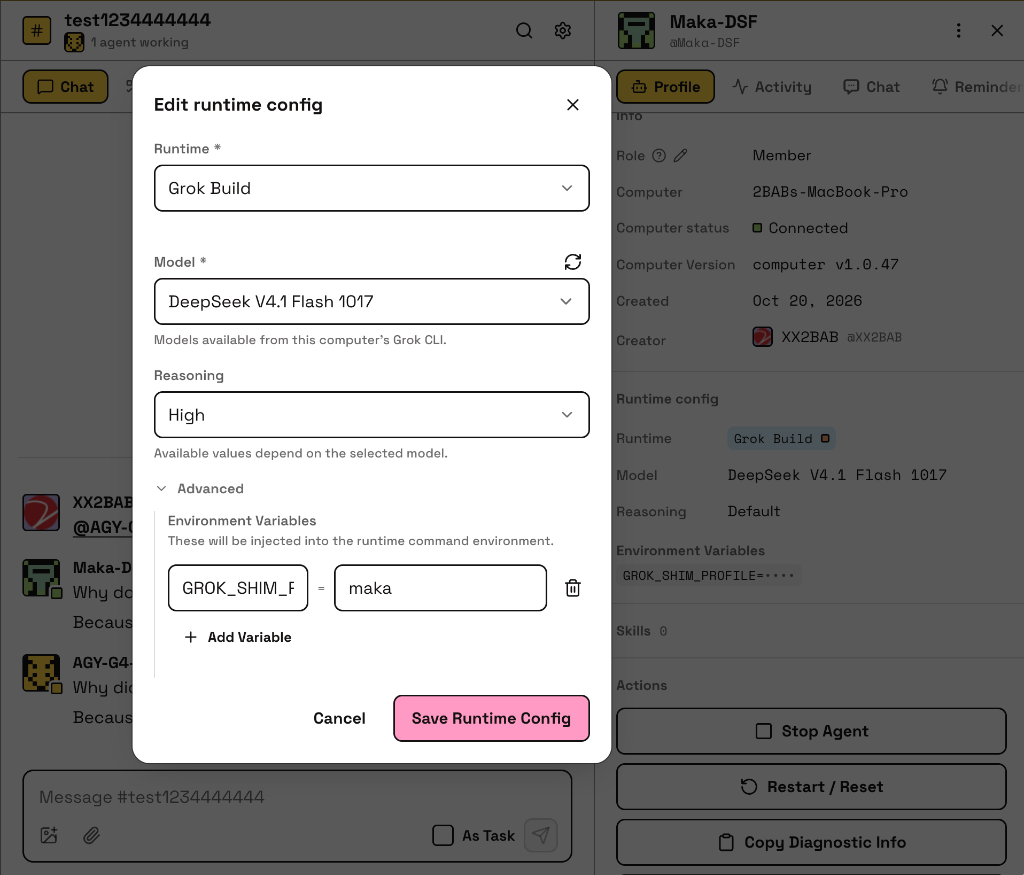
但紧接着就碰到了第二个问题:Raft 在探测这个 runtime 支持哪些模型时(grok.ts 里的 detectGrokModelsFromAcp),是在机器级别单独拉起一个 grok 子进程发 initialize 请求的,这个时候是 Agent 启动前,所以并不会带上某个具体 Agent 的环境变量。既然探测时不能靠环境变量区分 Agent,我就想到代理层返回的模型列表里,让模型 ID 自己带上 Agent 的路由信息:
- 早期探测(未设置
GROK_SHIM_PROFILE)时,代理层同时汇总多个 Agent 的模型目录,给所有modelId加上agy_或maka_前缀,比如agy_gemini-4-argon-medium、maka_deepseek-flash。 - 到了真正会话时,代理层先校验所选模型的 ID 前缀是否和当前 Agent 的
GROK_SHIM_PROFILE一致(比如maka的 Agent 误选了agy_开头的模型会立刻报错),校验通过后再把前缀剥掉,把真实的模型名发给后端。
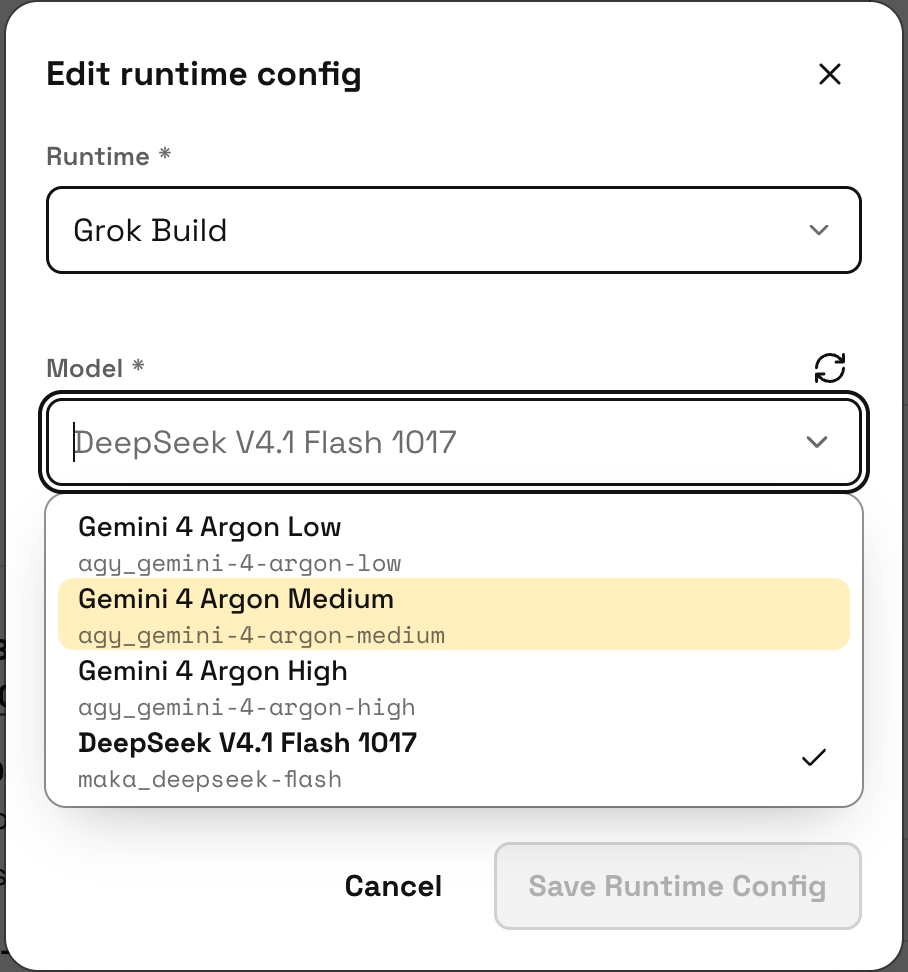
最后,万一我机器上未来也用上了官方的 grok CLI,只要把 Grok Build 渠道做透明转发即可(没有 Grok 会员,就没做实测啦)。
模型切换与 session/load:新旧 ACP 协议的对齐
有了前缀路由,接下来要真正把会话跑起来,首先得解决切换模型和推理档位(Reasoning Effort)的问题。
Raft 的 GrokDriver 切换模型调用的是早期草案里的 session/set_model,并把推理档位放在 _meta.reasoningEffort 里传过去。agy 识别的就是这套早期接口(对个人账号把档位编码进了 gemini-4-argon-low/medium/high 三个模型 ID 里)。
而 Maka 遵循的是严格的 ACP v1 规范,不去支持 session/set_model(直接返回 -32601)。在 ACP v1 的 Session Config Options 设计里,模型、推理档位等会话配置统一收敛到了 configOptions 数组,通过 session/set_config_option 修改。
Maka 后端本身已有切换模型的能力,但我们在给 Maka 这样的开源项目贡献代码时,显然不能为了迁就某一个客户端,把 session/set_model 或 _x.ai/* 这种非标准或厂商私有方法硬编码进 Maka 的 ACP 服务里。于是我给 Maka 提了 PR(apache/maka#6189),按标准规范在 configOptions 里把 model 选项暴露出来(只列出用户当前已启用的模型,并放开了适配层入口原本写死的配置项白名单)。
这里也能看出我们处理这类跨端适配时的三层分工(下一节的 Steer 也是同样的思路):
- Maka 端只改它自己的 ACP 适配层(
packages/cli/src/acp/),补齐的是 ACP 正式规范里本来就有、只是还没暴露出来的标准能力,可以直接合入上游; - Raft 端我们不可能去动它,
GrokDriver依然按它原本的逻辑发送session/set_model和_x.ai/*请求; - 中间的
grok代理层承担所有的协议转换工作,包括模型探测、前缀剥离、档位拆分和错误格式改写。
两边都不需要为了兼容对方去污染自己的代码,具体的转换逻辑全部收敛在代理层:
- 探测阶段:Raft 要求在
initialize阶段(创建会话前)就拿到模型列表,而 Maka 的configOptions是在session/new时才返回的。所以代理层在初始化时会先向 Maka 发起一次短暂的探测会话,读完模型和推理档位列表后立刻调用session/close销毁,避免在后台留下孤儿会话。 - 切换阶段:当 Raft 发来
session/set_model时,代理层将其拆成一到两次session/set_config_option调用,分别更新 Maka 的model和thinking_level。
另外在会话恢复(session/load)上也有个小细节:按 ACP v1 规范,session/load 成功时只返回配置项而不重复返回 sessionId。代理层一开始复用了新建会话的校验逻辑,硬性要求响应里必须带 sessionId,导致历史会话恢复一直报错;改成透传请求里的 sessionId,并将未知会话错误统一改写为 GrokDriver 能识别的 "session not found" 后,会话恢复和丢失重建就都通畅了。
忙时插话(Steer):协议 Hook 与 Maka 的改造实践
在 Raft 的多 Agent 群聊频道里,一个非常高频的操作是在 Agent 还在执行任务(当前回合尚未结束)时追发消息,临时补充上下文、调整需求或者叫停它。
要支持这个体验,两个 Agent 面对的情况不太一样:
agy 是闭源二进制(agy_acp_server.par),实测下来它从底层就不支持回合中插话:它的 ACP 服务没有定义 Steer 相关接口;如果在上一轮还没结束时强行并发调用第二个 session/prompt,底层会直接抛出并发异常,而且外层捕获异常后还会把报错文本当成普通聊天回复流式输出到界面上。更坑的是,它的 Python 基类 acp.interfaces.Agent 给扩展方法入口 ext_method 写了一个函数体为 ... 的默认空函数,导致发给它的任何 _ 开头扩展请求都会默认返回 result: null,也就是假装成功、实际直接丢弃。因此对于 agy,代理层只能采用折中方案:忙时收到新消息先放进内存队列,等当前回合执行完,再由代理层把队列里的消息作为新的 session/prompt 依次发出去。
而 Maka 是开源项目。我查看了它的源码发现,后台守护进程(Runtime Host)内部其实早就做好了回合中插入消息的调度逻辑,只是 packages/cli/src/acp/ 下的 ACP 协议适配层一直只调用了 turn.start,没有把“回合中插话”暴露出来。既然源码在手,我们就可以直接给 Maka 补齐真正的 Steer 支持(apache/maka#6192)。
协议边界:Grok 私有接口与 ACP 标准接口的转换
在动手改代码前,需要先理清两边协议是怎么设计的。
当会话处于忙碌状态时,Raft 的 grok.ts 不会再发送 session/prompt,而是先发送一个 Grok 私有的扩展请求 _x.ai/interject;如果后端返回 -32601 Method not found,它才会降级尝试 session/steer。
和上一节修改 model / thinking_level 的思路一样,我们不在 Maka 里去接 _x.ai/interject 这种私有方法,而是遵循 ACP 正式协议里关于回合中消息注入(Mid-turn Injection)的设计文档(RFD #1261、Schema #2043),在 Maka 的 ACP 适配层暴露一对标准接口:
session/inject:接收sessionId、content以及mode: "steer" | "queue"。其中steer表示在当前回合的下一个步骤间隙(比如工具调用结束后)立即把新消息交由模型处理;queue则表示排在当前回合结束后再执行。调用成功后返回服务端生成的messageId。session/revoke_inject:在消息真正被模型消费之前,允许客户端凭messageId把还在排队的消息撤回。
到了 grok 代理层这边,只需要拦截 Raft 发来的 _x.ai/interject,把它转换成 session/inject { mode: "steer" } 转发给 Maka 即可。
在 Maka 中接入 Steer 碰到的几个问题
Maka 的架构是“轻量的 maka acp 命令行进程 + 常驻后台的 Runtime Host 守护进程”。把无状态的协议请求映射到有状态的后台执行流时,碰到并解决了三个问题:
- 空闲状态下的时序差校验:异步通信里常有时序差,客户端以为 Agent 还在忙并发送了
steer,但服务端刚好执行完上一轮。Maka 后台收到插话请求时如果发现当前没有运行中的回合,默认会直接开启一个新回合;但这个新回合不是由标准的session/prompt发起的,ACP 适配层没有挂载输出监听流,客户端就完全收不到它的回复。因此适配层在转发前必须先核实会话确实处于运行态,若已空闲则直接报错拒绝。 - 撤回消息时的并发竞态:客户端撤回排队消息时,如果正巧赶上模型在几毫秒前刚把这条消息取走开始执行,后台会返回“状态冲突”而非“消息不存在”。但对客户端来说,这两种情况都意味着“消息已被消费、来不及撤回了”,适配层需要把这类竞态异常统一归并为同一个状态码返回。
- 后台守护进程重启后的连接状态同步:Maka 后台每次启动都会生成一个新的进程标识(
hostEpoch),要求写请求携带该标识以拦截跨重启的过期指令。早期 ACP 适配层在初始化连接时把标识存成了静态属性,导致后台重启并自动重连后,后续插话请求因为一直携带旧标识而全部失败;改成每次请求动态读取活动连接的当前标识后才解决。
顺手抓到的 Raft Bug
代理层的离线测试全部通过后,我切回发行版的 Raft v1.21.24 准备验收,结果在 Settings -> Runtimes 里点击扫描后,所有本地 Agent(包括 Claude Code、Codex 和 Grok Build)全部显示未安装。
查了 ~/.slock/computer/logs/service.log 和 raft-source 里的 runtimeDetectionRound.ts 才发现:守护进程在拉起探测子进程时,默认把 process.argv[1] 当成了入口脚本路径;但在打包后的 Electron 应用里,argv[1] 其实是启动模式参数 "__service",导致子进程在 ELECTRON_RUN_AS_NODE=1 下把 "__service" 当成根目录下的文件去加载,直接报错 Cannot find module '/__service' 退出。
我已经把这个问题整理成复现报告提交给了 Raft 开发者,在官方发版修复前,本地用 node 启动编译好的 raft-computer.js 守护进程即可暂时恢复。
小结
整个 grok 代理层约 1,400 行 Node.js 代码(零第三方依赖),十分轻量。使用前只要:
- 下载配置好 Antigravity 的 ACP 依赖;
- 确保 Maka 的守护进程处于运行状态(
maka runtime-host status); - 在 Raft 里建两个基于 Grok Build 的 Agent 并分别配上
GROK_SHIM_PROFILE=agy和GROK_SHIM_PROFILE=maka,就能拉进同一个频道里协作了。
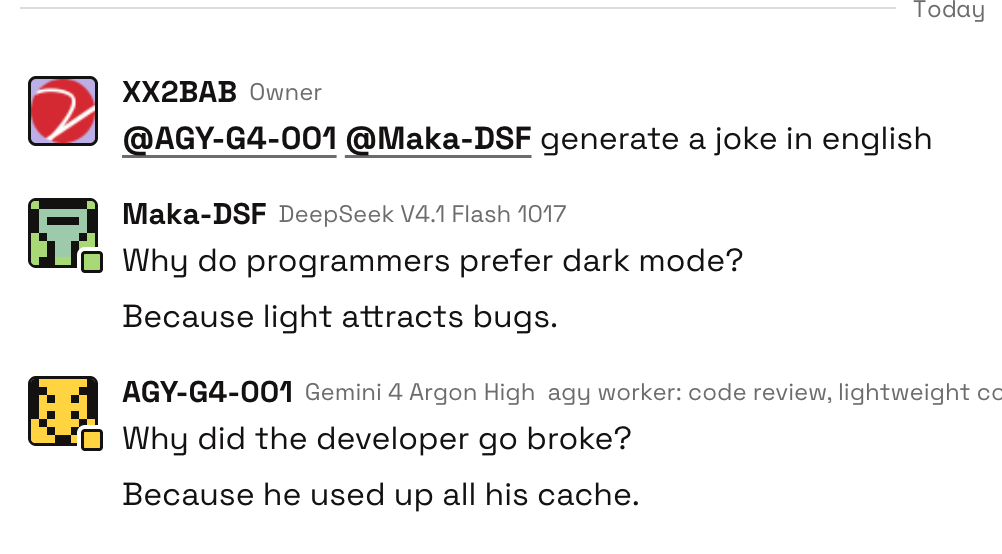
而即便未来协议有升级,例如 grok 支持了新的 ACP mid-turn steering,我们的修改成本也极低且频率不会太高,是一个长期可行的兼容方式。
我自己这一圈折腾下来,有两个想法:
- 一是 ACP 目前虽然也还不完善(比如早期草案与 v1 规范的分裂、Steer 等能力还在演进提案阶段),但在现阶段已经是一个实用的通用接口选择。以前每个桌面客户端想接入新的编码 Agent,都得专门为它的 CLI 参数和输出格式写一套适配代码;一旦两端都往 ACP 靠拢,中间哪怕有些版本和扩展上的差异,也能用一个轻量脚本去抹平。
- 二是把源码开放出来确实能获得不少来自社区的帮助。不管是这次给 Maka 补齐 ACP 的 Steer 和模型配置支持,还是顺手帮 Raft 定位到打包版的 Runtime 探测 Bug,都是因为能直接读到源码才得以快速推进。目前
raft-source仓库还暂不接受 issue 或者开放 discussion,也希望 Raft 团队后面想清楚社区协作的方式后,能开放更多的讨论和贡献空间。