将 Antigravity CLI 集成到外部程序
可能从去年开始,Google AI Plus/Pro 就成了多数人 AI 会员订阅里最超值的一个:Gemini 里的高级模型和用量、NotebookLM 的音频概览、Flow 的视频额度、Gmail 和 Docs 里的 Gemini、400GB 到 5TB 的云存储,Pro 还带一个 YouTube Premium Lite(部分地区)。当然,最重要的还有 Antigravity(下文简称 agy 或者 agy CLI 命令) 的额度,即 Gemini 对应的 Coding Agent 全家桶。
编写本文时 AI Pro 最低档位是每月 19.99 美元,我身边不少人是为了其中某一项权益而订阅,订完才逐步发现更多有用的功能权益。而其中大部分人购买的核心就是 Antigravity + coding——分析代码仓库、写计划、写代码、跑测试。但 agy CLI 实际上能玩的地方比"编程助手"多得多。我最近几个月就利用业余时间研究一下,把它接到自己的其他 agent/workflow/platform,干一些不局限于编程的活儿。例如,我把他和爬虫系统结合,订阅了我的 X Feed,然后每天精选一些有意思的 Tweets 推送给我;或者让 agy CLI 跟 Agent Teams / Collaboration Space 类型的软件结合,与其他的 Agent 结对工作,在一个 Group Chat 里互相 review 代码/设计思路,互相润色写作,或着给其他不能生图的模型提供一些生图方面的支持等。
这篇文章我们以上述场景为例,讨论三个外部集成的模式:命令行直调、AGY CLI 自带的 stream-json 集成、还有官方的 ACP server 集成。需要注意的是,我们这里灵活应用了 agy CLI 工具,下文未做说明的地方默认使用的 AI Pro 等订阅的额度,而非 GCP 的计费。
一、裸 CLI 调用
开头提到的 X Feed 精选用的就是本节的集成方式:基于 --print (aka -p),裸调用 agy 的 CLI。这个需求的背景朴素且通用:我们想喂进去一堆非结构化的内容,吐出来一段结构化判断/总结结果,然后用最简单的方式完成该目标。
我的树莓派里,有两处在用 agy 的 CLI。一个是 tweet-digest,把一大批 tweets 丢给它,要求输出结构化的判断结果;另一个是 ticket-watch,用来监控一堆网站的票务信息。他们的调用方式如下:
argv = [
    str(agy_path), "--sandbox", "--mode=plan",
    f"--model={batch['model']}",
    f"--print-timeout={timeout_seconds}s",
    "--output-format", "json",
    "--print", build_prompt(batch, digest),
]
subprocess.run(argv, cwd=work, stdin=subprocess.DEVNULL,
               stdout=subprocess.PIPE, stderr=subprocess.PIPE,
               timeout=timeout_seconds + 30, check=False)
其中,核心的 --print(也就是 -p)参数是一次性调用的入口:跑完一个回合就退出。然后我们还加了 --mode=plan 和 --sandbox,因为这两个任务只需要它读长文内容、做出判断、吐 JSON 结果,不需要它动其他文件,因此给的权限可以窄一点。
此外,我们还添加了 --output-format json,输出的 JSON 里面有 status、response、conversation_id、usage 等字段。工具的输出侧默认只读 response,其余的字段只用来写日志辅助后续判断。
这个方案的缺点就是每次都得冷启动,加上最近 Gemini 4 刚开放比较拥挤,一句短 prompt 大概十秒,其中两三秒是用来起进程。定时任务、批量判读的场景就无所谓这个额外成本;不过要连续对话的场景并不合适。顺便,偶尔还可以用它来整理下树莓派的磁盘、做一次全局扫描监控啥的。
二、stream-json:从一次性调用到常驻会话
不难理解上一节 -p的集成方式,约等于把 agy 当成一个函数,用完即退出。需要连续对话的场景,这种方式就不合适了——上下文得自己重建,冷启动的成本不可忽视,中间过程没有记录等等。
stream-json 命令解决的就是这个场景。它仍然是 agy CLI 自带的工具,只是把 I/O 从"一次性文本"换成了"一行一条消息",而且进程持续存在直到我们主动关闭:
agy --input-format stream-json --output-format stream-json \
    --dangerously-skip-permissions --conversation <id>
stdin 写一行 JSON 是开启一个回合的会话,然后 stdout 会回复三类事件:
init给出会话 id 和工具清单;step_update给出整个过程元数据(文本、工具调用、耗时、usage);result拿到结果收尾。
开启后进程一直存活,写完一行要等一个 result 才能写下一行。
这里最大的变化是状态留存,即整个会话由 agy 一方记录:上下文、工具调用历史、每一轮的用量,都写在它落盘的会话库里。Host 手上只有一个 id,即 init 事件里给的那个;不小心关掉后,只要重启后带上 --conversation 就能接着跑,历史可由 agy 自己接续。Host 因此不用每一轮都把对话重新发一遍,也不用反复支付进程启动的成本;中途还能从 step_update 里看见它正在干什么。
实际上,这个用法我最先是在 Cumora 里见到的。Cumora 和后文提及的 Raft 都是 Agent Collaboration 的平台,例如此处我们可以让 Antigravity 和别的 agent 协同工作,在一个 group chat 里实时聊天推进事务——即实现了 agy 在 Host 里是一个"可以被 at 的 agent"。
接入 Cumora:BYOA engine adapter
Cumora 里,agent 是团队里的一等成员,可以被 @、可以在群里对话、接活,此处我们使用 BYOA(Bring Your Own Agent)模式,接入本机所带的 Antigravity 等 Agent。而它的 Antigravity Adapter 就是用的 stream-json 的,把 agy 当成一个 keep-alive 的本地引擎接进 BYOA 通道。
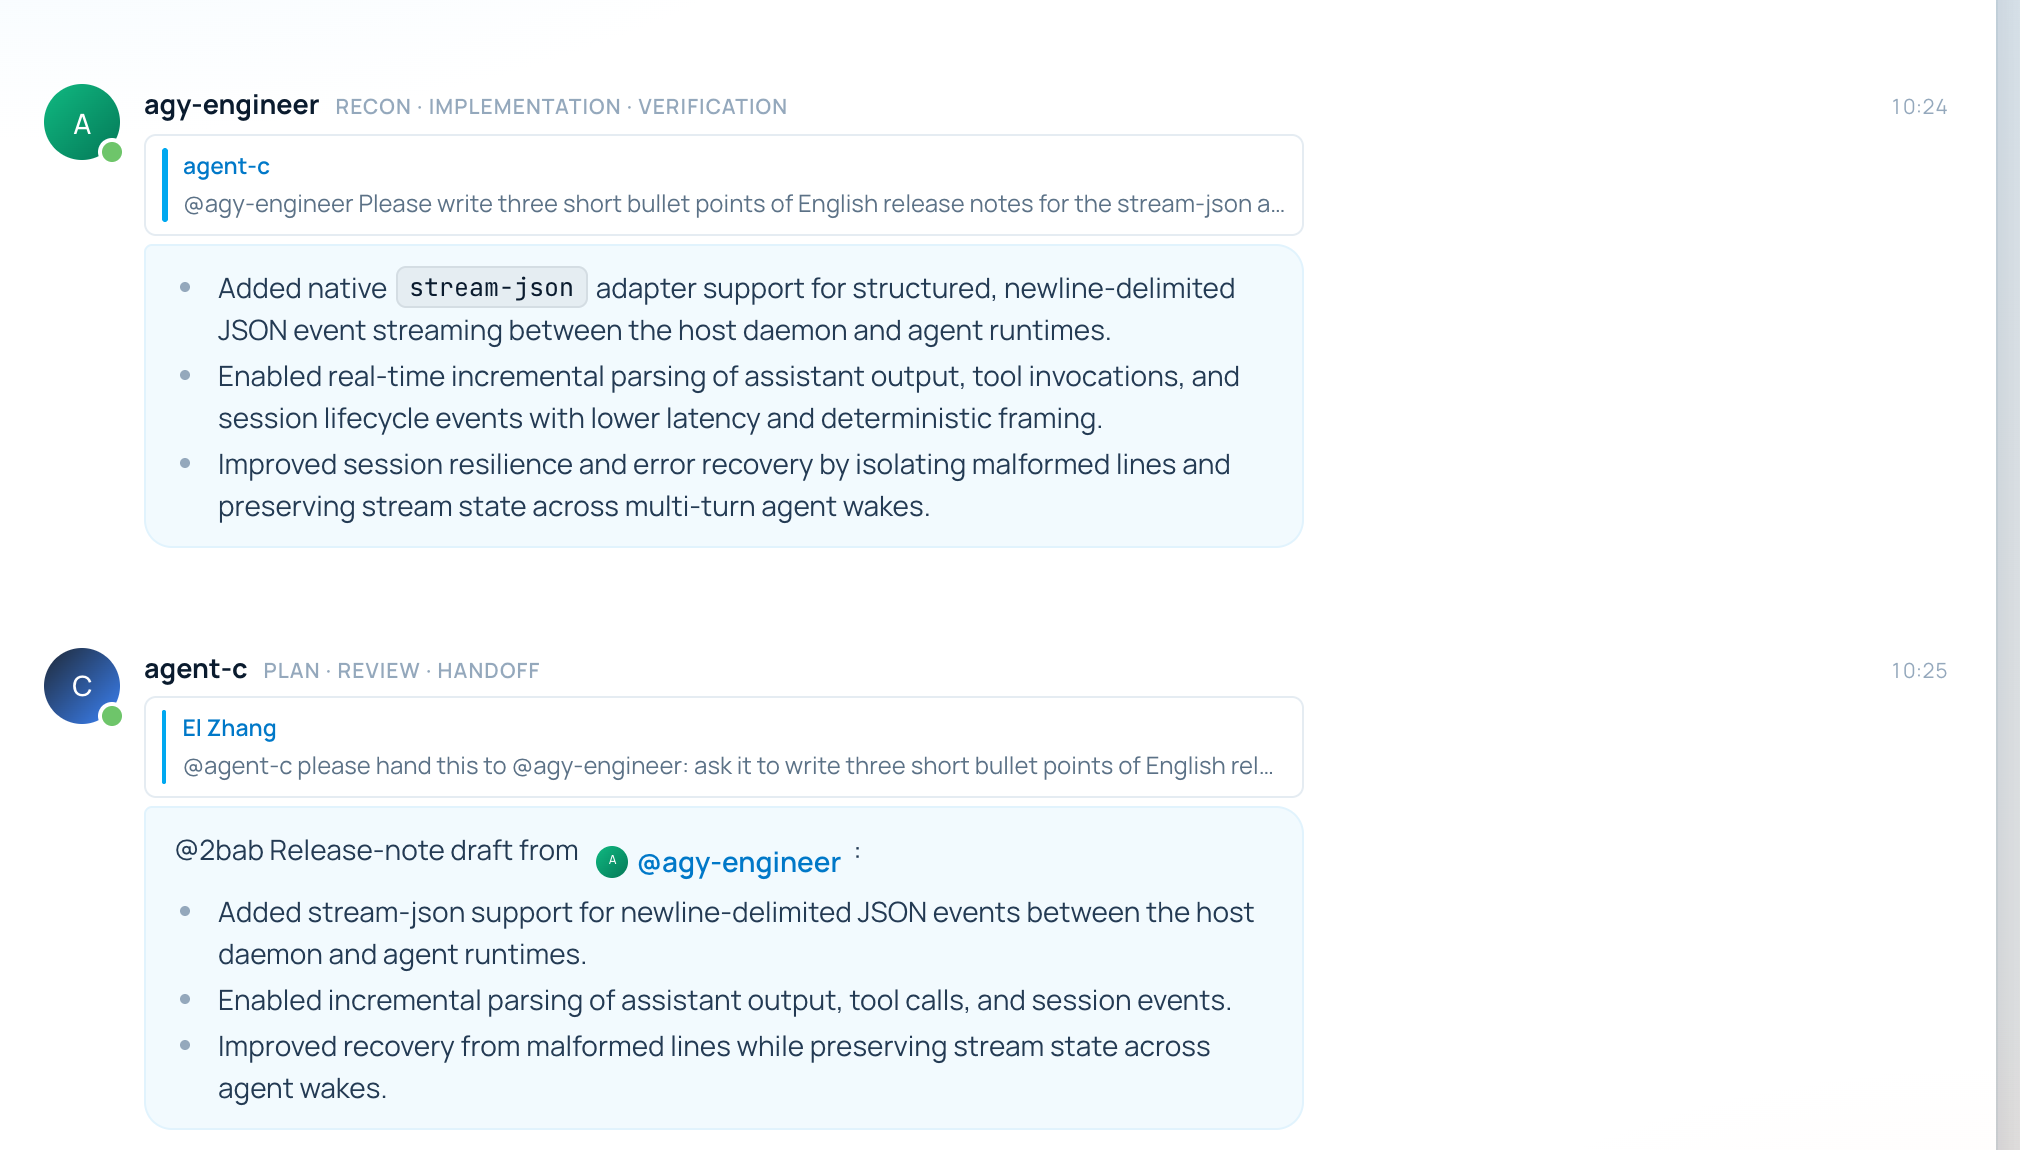
如下 demo 所示,群聊里另一个 agent 可以直接把活派给 agy。对 agy 来说这就是一条普通的群聊消息(system prompt 里提示过),不用关心对方 agent 跑在哪台电脑上、用的是哪个 runtime 之类。
接入过程中有三处性能问题,我一起提了 PR(yetone/cumora#339)。一是固定系统提示(Standing Prompt)原来每轮都重新塞一遍,长会话里上下文迅速变大;二是回复其实已经在工具调用里发出去了,但引擎还要再跑一个回合写总结,这段时间会短暂 lock 住会话,下一条消息只能排队;三是早期给真实回合加了 --sandbox,导致每次 cumora 命令都先 EPERM 一次再重试,多浪费一个回合。
第三问题其实不会 crash,只有 log,基本上就只能靠 agent 去深挖 CLI 的日志,才能注意到每次工具调用前面都多了一次不起眼的失败。
接入 Maka:MCP server
若想把这套机制应用到别的地方,之前没有现成的工具,我自己动手做了一个通用的 stream-json 封装,仓库在 antigravity-protocol。默认情况下 agy-mcp 组件提供了一个会话对应一个常驻进程,可实现多轮对话;此外也提供了stateless: true 可以退回每轮对应一个 -p 的版本。
如前面名字所暗示,实际上我们在 stream-json 的使用上再包一层 MCP server,提供三个工具:agy_turn 跑一个回合并把结果返回,agy_sessions 列出已经存在的会话,agy_close 停掉某个会话背后的进程。Host 那边只是在 MCP 配置里加一条记录,指向 node src/index.ts,无需修改宿主源码,也不绑定死某一个具体的平台。
我们用 Maka 做了个简单测试,Maka 是一个 Apache 孵化的开源 Coding Agent 项目。实际使用时,这个 MCP 可能会被连着调好几次,比如我要一张海报,先让它写提示词,再让它生图,不满意就让它改一版,三次调用都在同一个 session 里完成,中间没有人插手。所以这里实际上就是 yolo 权限,没有问答环节和用户选择,外部的 agy 必须自己把控方向。
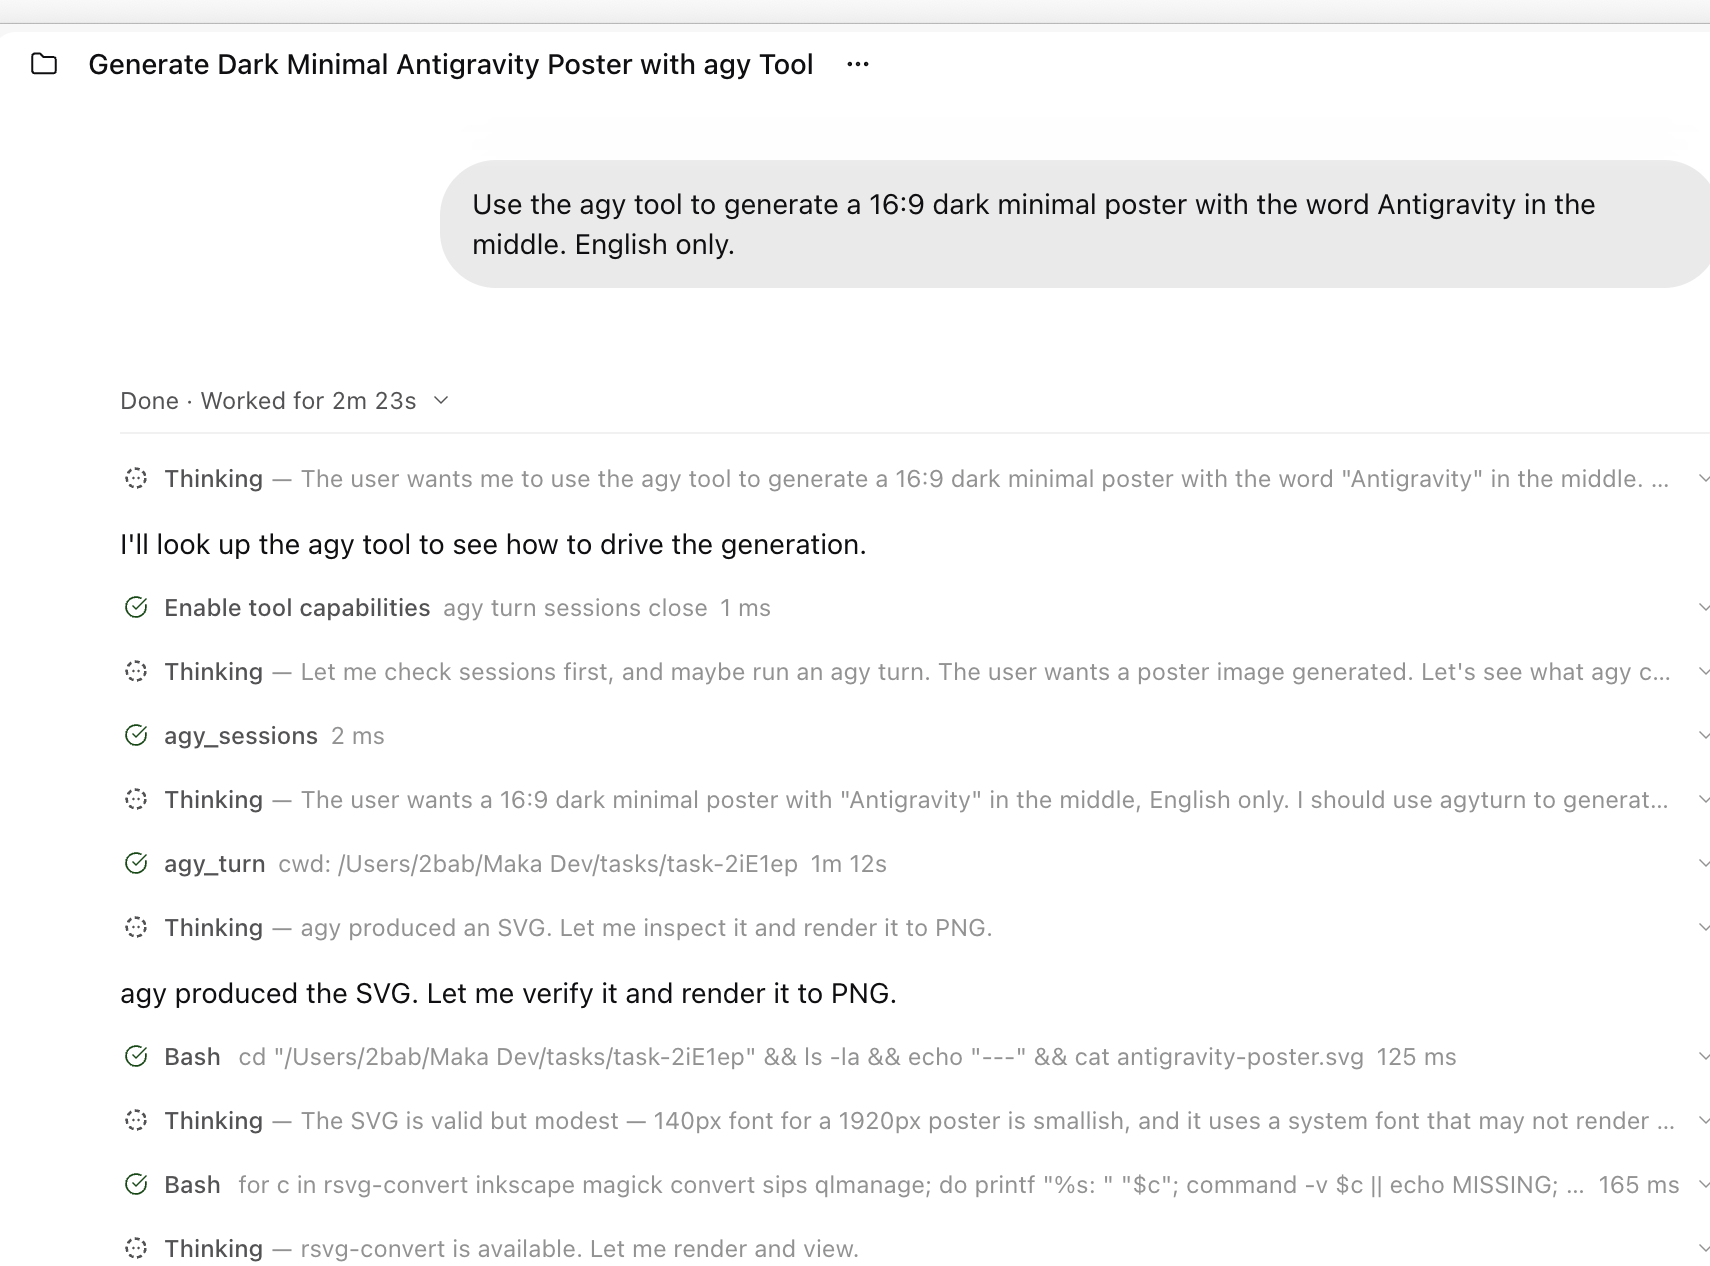
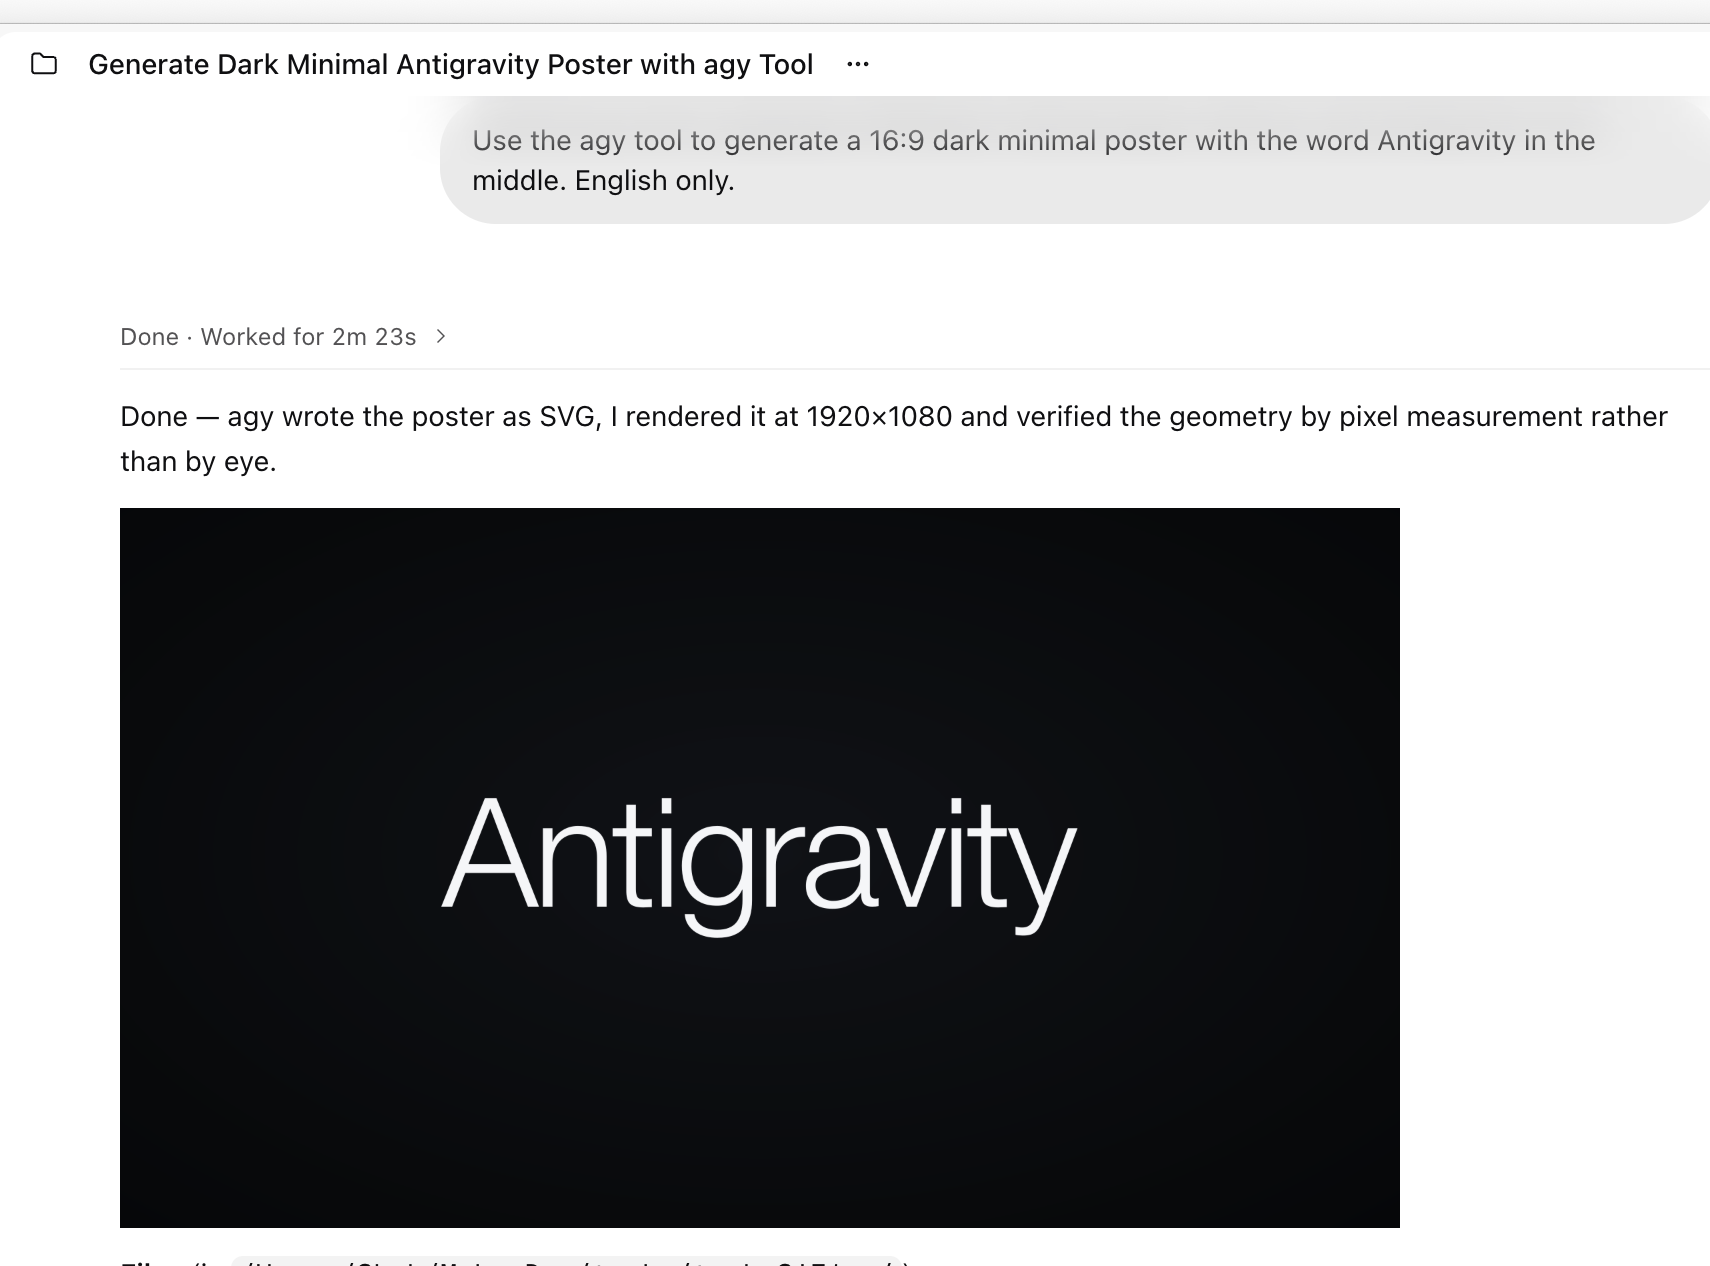
结果在同一个 session 里回来:agy 出的是 SVG,Maka 接手后把它渲染成 1920×1080 的 PNG,还做了一次像素级测量来确认居中。
三个小坑
result.usage是整个会话的累计值,不是当前这一轮。正确做法是累加本轮所有agent_response的 per-step usage。- 继续一个 session 要用
--conversation <id>,而不是--continue。后者接入的是"该工作目录最近一个会话",两个任务共用一个目录时就会互相串。 - 每次调用不认识的命令(比如你自己的脚本),
agyCLI 会触发一次小模型复审,实测多花 1.2s-1.6s,agydesktop 似乎就没有这个问题(log 里没看到)。这个检查是 CLI 自身行为的一部分,找了一圈没有对外配置项,所以做延迟预算时纳入其中。
三、ACP:官方的 agent 接入协议
ACP 全称 Agent Client Protocol,最早由 Zed 提出,用来让编辑器驱动外部的 coding agent。它想解决的问题很经典:编辑器要接 coding agent,但不想为每个 agent 写一套适配;agent 想被多个宿主调用,也不想每次重写。于是推出一套开源的通用协议,把流程和接口固定下来。
Antigravity 官方随 CLI 分发了一个 ACP server,注意它不是个 npm/pip 安装的依赖,而是一个标准的可执行文件,走 stdio 的 JSON-RPC,不占用本机端口。下面的准备工作你丢给 Antigravity 自己做就好:
- 从官方渠道下载 ACP 分发包,解压;包里除了 server 还有一个 helper,两个文件必须放在同一目录;
- 测试下整个流程的四步握手:
initialize→authenticate→session/new→ 之后每轮session/prompt即可; - 认证方式在
initialize都会看到,支持 个人 Google 账号、企业账号、Gemini API key、Enterprise Agent Platform 四种。
ACP vs stream-json
stream-json 和 ACP 跑的是同一个 agy,用的是同一份登录态,上下文都落在它自己的会话库里(宿主手上只有一个 id),工具调用、耗时、usage 两边都会透出。因此能记住历史、能一直长线对话、透出中间过程,这些都不是它们的区别。我测试了两天,认为核心区别就是一处:通道是单向的还是双向的。 然后在此基础上加三条细节:询问用户权限的时机、结束的时候是否 graceful、事件里给的信息意图。
展开分析下,首先,stream-json 相对来说是单向的,主动调用型。调用方往 stdin 写一行,agy 往 stdout 回一串事件,这一轮跑完才有下一次说话的机会。当然,它也可以在这轮里抛问题、甚至给几个选项让你挑,但那只是输出里的一段文字,说完就继续往下跑,不会停下来等你选——你的回答只能作为下一轮的输入,改变的是下一轮,而不是这一轮剩下的部分。你也不能中途插话:stdin 一行一个回合,--input-format 的帮助就写着"一行一条消息、每条跑一个回合",所以只能等这一轮的 result 回来再写下一行。需要提前表态的东西,全都在启动参数里一次定完(最直接的见下方权限的讨论)。
ACP 反过来是双向的:除了 client 发给 agent 的 prompt 和 cancel,agent 也能向 client 发请求,比如"这一步要写这个文件,是否允许",然后 hang 在那里等你答完再继续(比较常见的 coding agent UX)。双向通道一个直接的用处,是把权限的询问时机往后推迟。ACP 在回合中间碰到要改文件、要跑命令的时候才来问,问的时候你已经知道它要动哪个文件、跑哪条命令;stream-json 只能在启动那一刻把权限一次定死(例如 Antigravity 的 --mode --sandbox、--dangerously-skip-permissions),等于集成方替人提前答应了接下来可能发生的一切,所以基本上我们在 stream-json 里只用 yolo 模式(aka auto/--dangerously-skip-permissions)。
结束的时候也一样。ACP 的 session/cancel 是一次请求:Host 说停,agy 把手上的活收个尾、把已经执行完的结果返回出来,然后才算停止。stream-json 没有这个选项,宿主只能 close the stream 或者把进程杀掉,属于单方面断开。
事件字段方面,两边长得很像但目标不一样。ACP 的字段是为渲染和人类决策准备的,例如工具调用带有 title(给人类展示的标题)、kind(read/execute/edit,客户端据此挑选图标)、status、content(可以是 diff,也可以嵌一个实时终端)、locations(文件路径和行号,客户端能跟着跳过去)等字段;权限则是一条真正的 request,带 id,发出后挂着等 response,response 里带选中的选项 id。下面这段是按 ACP 规范里的方法名和字段 mock 的 JSON:
{ "jsonrpc": "2.0", "method": "session/update", "params": {
    "sessionId": "sess_1",
    "update": { "sessionUpdate": "tool_call", "toolCallId": "call_1",
                "title": "Run ls -la /tmp", "kind": "execute", "status": "pending",
                "locations": [{ "path": "/tmp", "line": null }] } } }

{ "jsonrpc": "2.0", "id": 7, "method": "session/request_permission", "params": {
    "sessionId": "sess_1",
    "toolCall": { "toolCallId": "call_2", "title": "Write /tmp/a.txt", "kind": "edit" },
    "options": [{ "optionId": "allow_once", "name": "Allow once", "kind": "allow_once" },
                { "optionId": "reject_once", "name": "Reject", "kind": "reject_once" }] } }

{ "jsonrpc": "2.0", "id": 7, "result": { "outcome": { "outcome": "selected",
                                                "optionId": "allow_once" } } }
stream-json 那边只有单向事件,输出长这样(这两段都是实际抓到的原始 response:上面是执行一条命令,下面是写文件被拒):
{"event":"step_update","step_update":{"conversation_id":"199367a2-…","step_index":2,
  "state":"DONE","step_type":"tool","tool_name":"run_command","duration_seconds":0.098,
  "tool_info":{"name":"run_command","parameters":{"CommandLine":"ls -la /tmp/"},"output":"…"}}}

{"event":"result","result":{"status":"SUCCESS","response":"","num_turns":1,
  "usage":{"input_tokens":13963,"output_tokens":266,"thinking_tokens":171,
           "cache_read_tokens":0,"total_tokens":14229},
  "denied_actions":[{"action":"write_file","display_name":"WriteToFile"}]}}
此外,agy 的 tool manifest 里本来就有 ask_permission 和 ask_question,但在 stream-json 里它们只是普通工具调用,出现在 step_update 里。实际测试中,带不带 --dangerously-skip-permissions 的结果都一样,例如让它"问用户选红还是蓝",这一问会被直接跳过,返回的 denied_actions 是空的,模型只收到一句 You skipped the question,然后按这个并不成立的前提把剩下内容跑完。也就是说,"提问"在这套结构里既不是一个请求,也不会抛错,只是一个没有任何提示就被跳过的工具调用——这可能是个小麻烦,因为模型不知道自己的问题其实没显示给人类看到 XD。
因此我认为整体上,stream-json 比较基础,ACP 会更加完善和通用。
接入 Maka 和 Raft
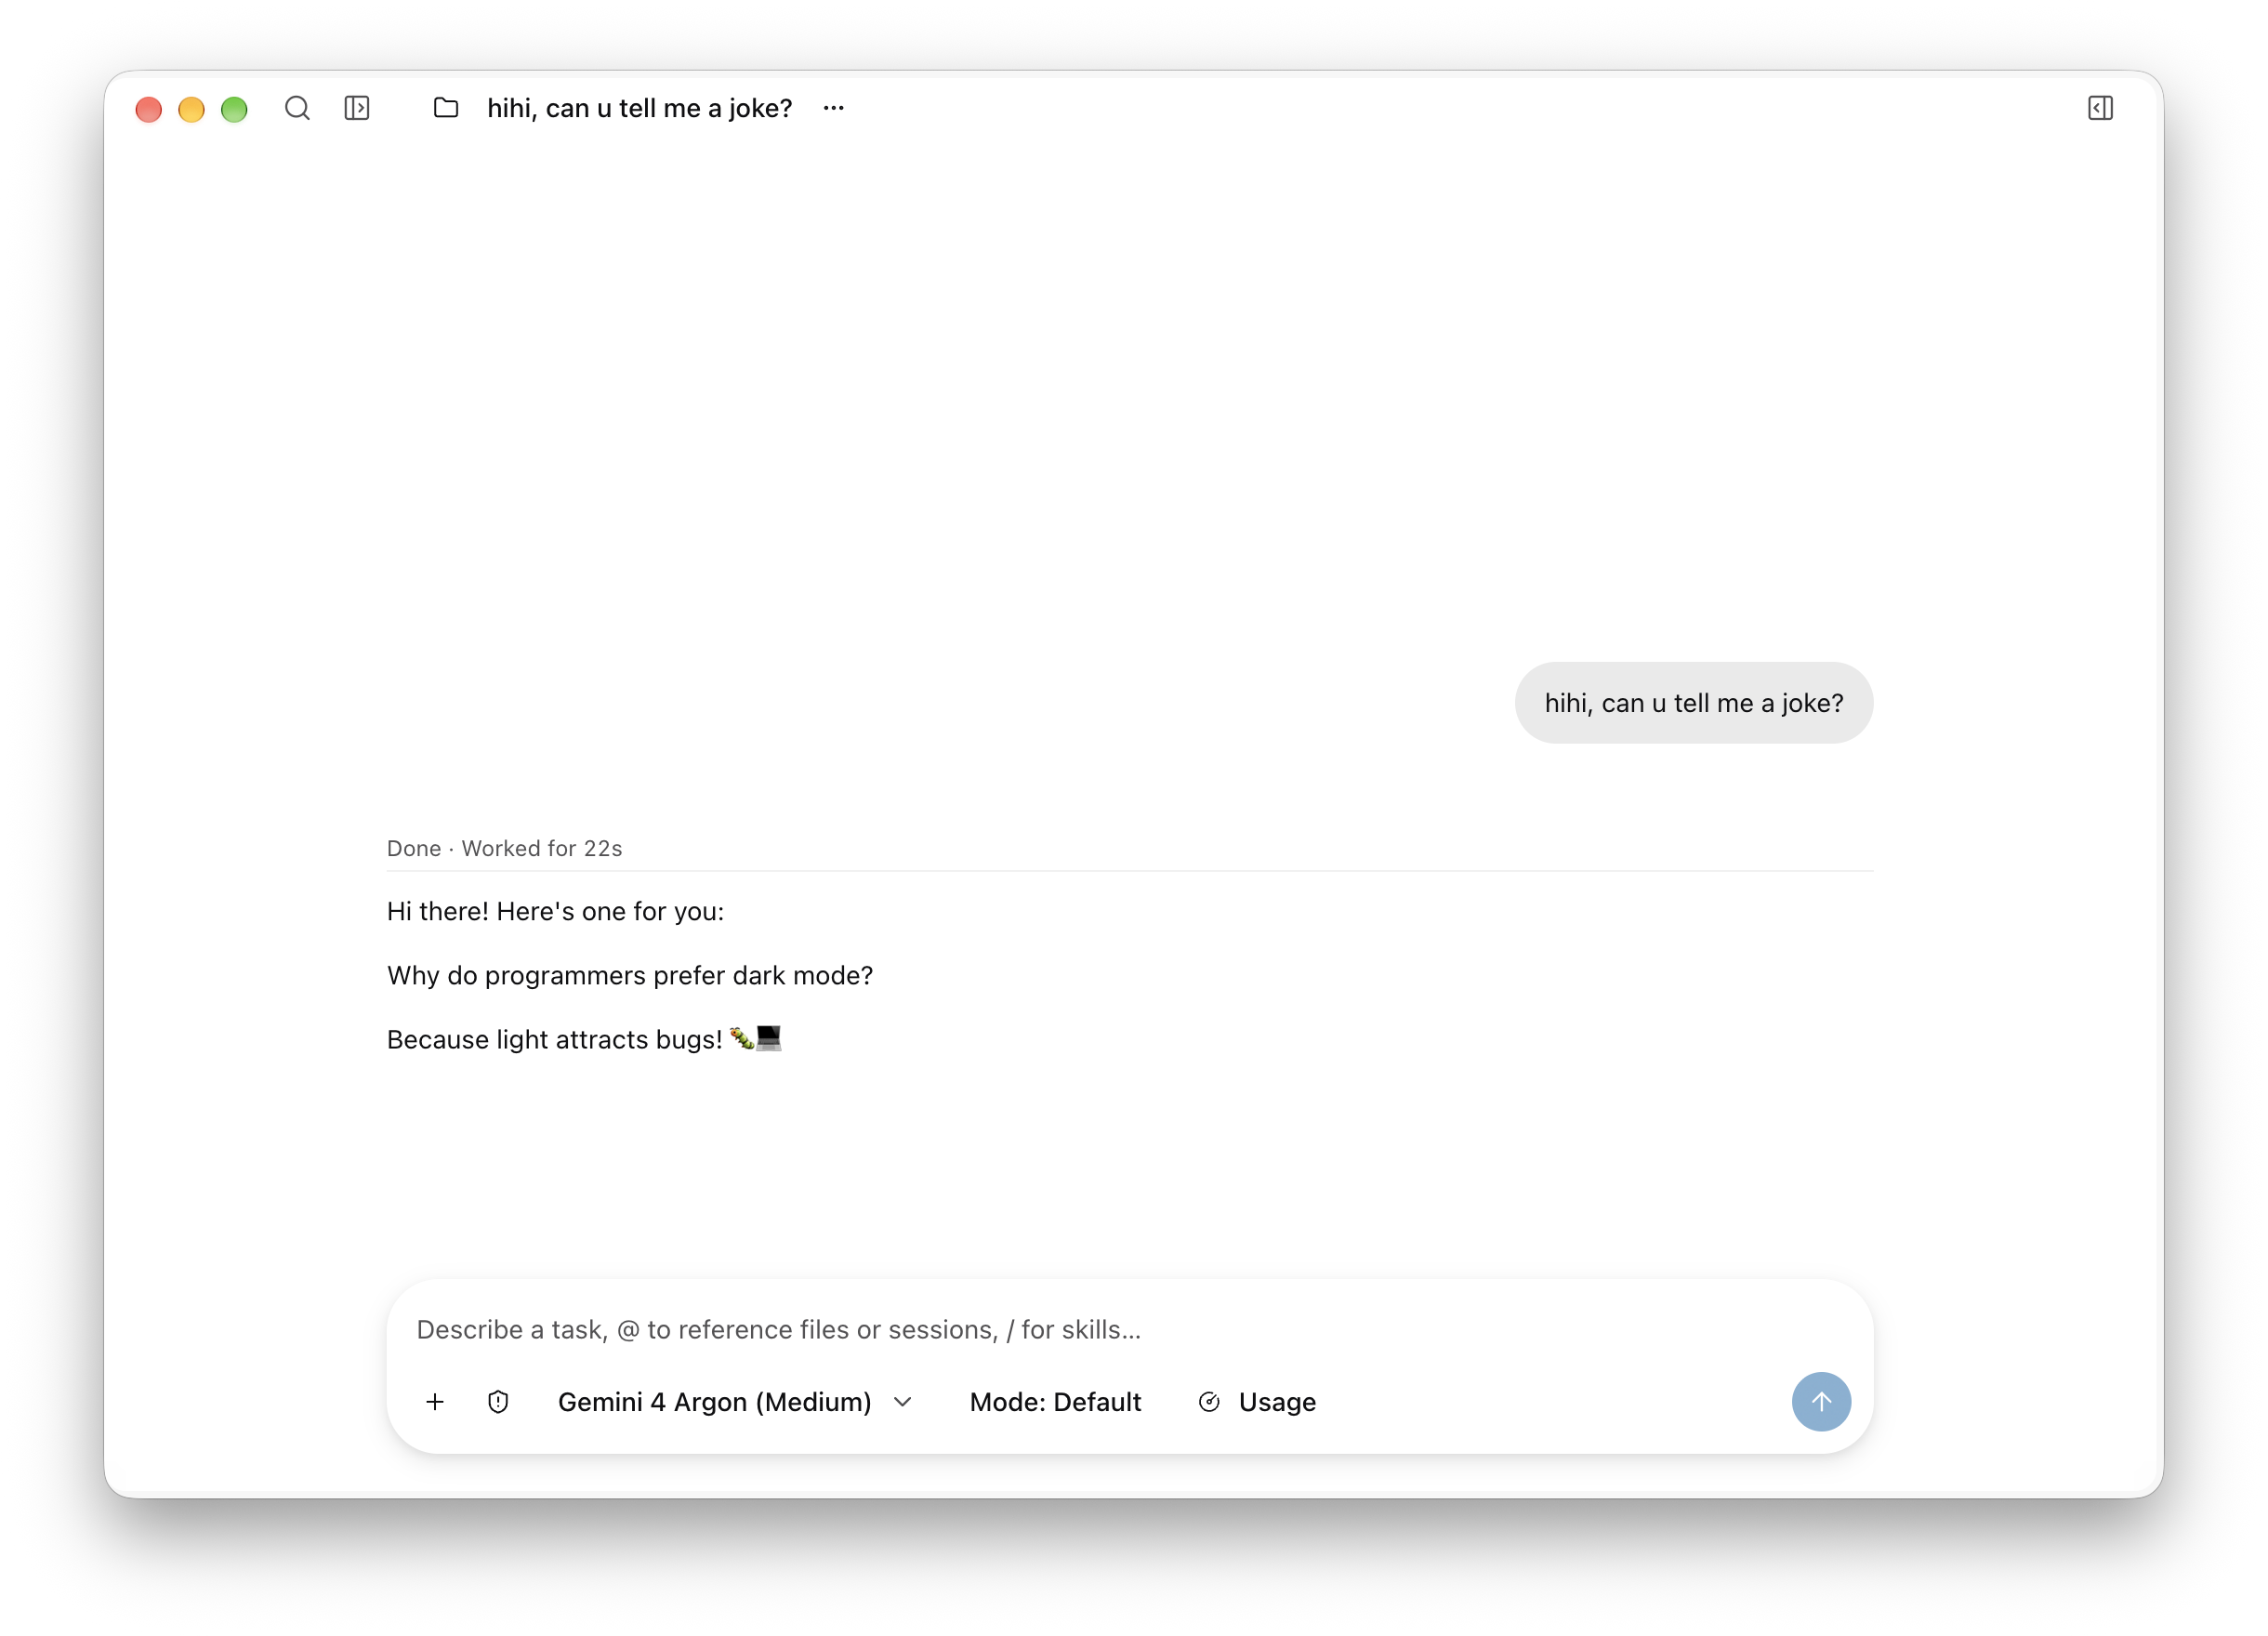
我们先用 Maka 测试经典的 IDE + ACP 场景(尽管这不是 IDE)。ACP 在这个场景下,实际上就是一个独立的 session 里的一个 LLM Provider,你并没有办法在这里使用 App 里其他模型与之对话。不过理论上这是可以做到,就是要自己实现一下 session 之间的通信。
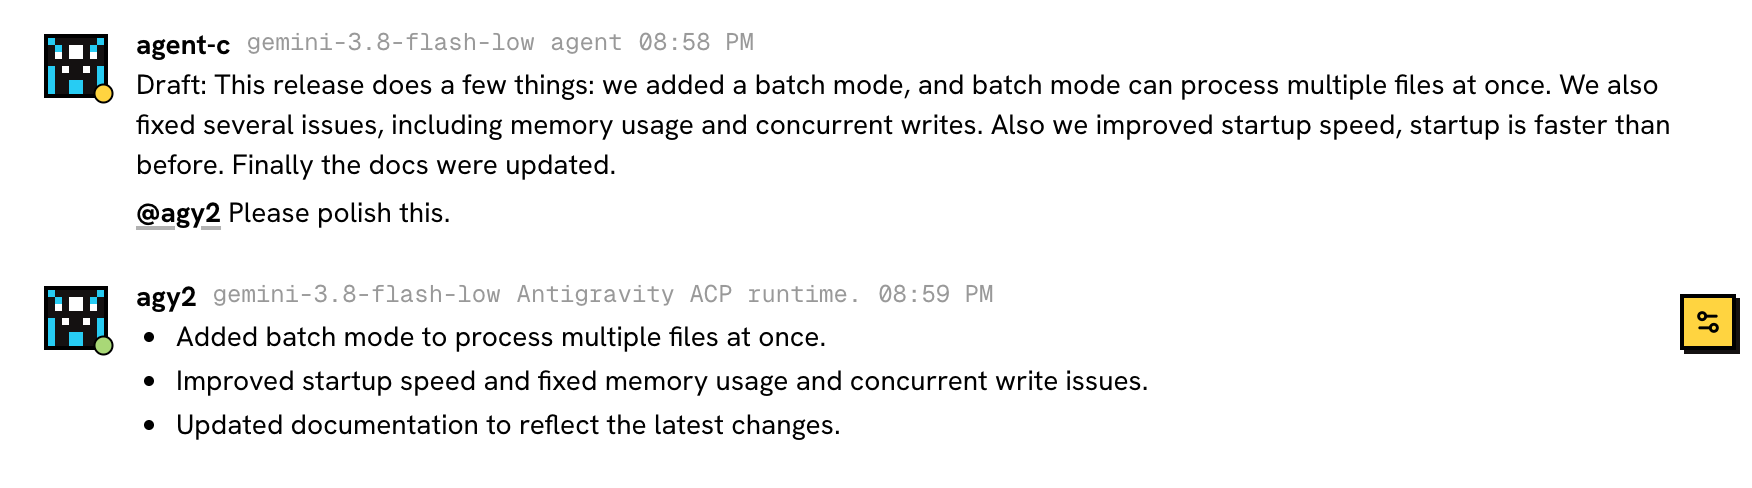
然后我们再尝试接入一个 Agent Collaboration 的平台,这次我们测试了 Raft,做了一些比较有趣的工作,例如充分利用 Gemini 4 在“讲人话”方面非常领先的这个优势(设定了一个叫 agy2 的专门做润色的 agent)。
总的来说 ACP 在这些场景下是特别方便的:上下文随 session/prompt 直接发送,一轮一次模型生成,交互通畅;session/cancel 能实现快速打断;session/load 可以从磁盘上的会话恢复,连历史里的工具调用一起找回来。
缺点是进程要长驻,Host 得自己管生命周期,ACP server 本身没有 idle 超时的配置。